専門知識や機密情報を扱う現場に広がるローカルLLMへの期待
昨今、LLMの高性能化に伴い、LLMやAIエージェントを活用したサービスが数多く提供されるようになってきました。
LLMの軽量化技術も発展してきており、自由に利用できるオープンウェイトモデルが公開されるようになりました。特に、高性能な環境を用意しなくても手元の端末で動かせる「ローカルLLM」も次々と誕生しています。
ローカルLLMは、モデルを自由に調整(≒ファインチューニング)できることから、自社の専門知識や固有のノウハウを学習させた「自分たちに最適なモデル」に仕上げられることが期待されています。加えて、機密情報を外部に持ち出さずに使えることから、従来のパブリックLLMの活用が難しかった業界(金融や保険、医療、製造などをはじめとした様々な業界)でも注目されています。
本コラムでは、ファインチューニングという技術の基礎的な考え方から、2025年12月頃に技術習得を目的として実際に手を動かした挑戦内容をご紹介します。専門知識や機密情報を扱う中で、ローカルLLMやファインチューニングを用いた生成AI活用を検討されている方にとって、ご参考になれば幸いです。
ローカルLLMの活用イメージ
例えば保険業界では、図1のように、プライベートクラウドなどネットワークが閉じた環境でローカルLLMを稼働させることで、業界知識や商品知識、応対記録といった機密性の高い情報も安心してファインチューニングやRAGに用いることができます。これにより、商品検索や保険査定、問い合わせ対応など様々なサービスへの活用が考えられます。
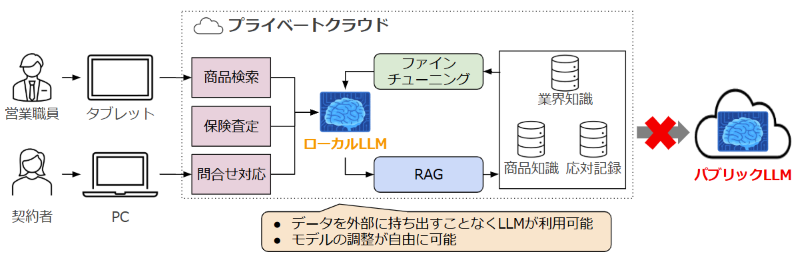
図1. 保険業界でのローカルLLM活用イメージ
さらに、ローカルLLMは開発現場でも力を発揮します。GitHub CopilotやClaude Codeといった昨今のAIコーディングアシスタントに組み込むことで、自社やプロジェクトに関する知識を反映したドキュメントやコード提案が可能になるだけでなく、利用コストの節約にもつながると考えられます。
ファインチューニングの流れ
ファインチューニングは一般的に、図2のようなステップで進めます。
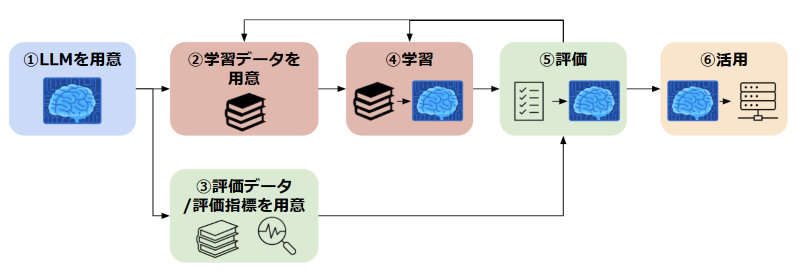
図2. ファインチューニングの流れ
- 1.
-
LLMを用意:ベースとなるLLMを選定します。
- 2.
-
学習データを用意:モデルに学習させたい知識や振る舞いを、学習データとして用意します。なお、モデルの特性によっては、学習データの形式が若干異なる場合があるため注意が必要です。
- 3.
-
評価データ/評価指標を用意:学習後のモデルの精度を測るため、学習データとは別に評価データと評価指標を用意します。評価指標では、例えば、モデル提供後の回答の質を評価するための基準や算出方法を定義します。
- 4.
-
学習:用意した学習データを使って、モデルにファインチューニングを施します。学習用パラメータの組み合わせが成否を左右するため、1回の学習で完了するとは限らず、試行錯誤を重ねながら進めるステップです。また、ここから先のステップではGPU環境が必要になります。
- 5.
-
評価:学習済みモデルが期待通りに振る舞うかを、評価データと評価指標を使って評価します。基準を満たさない場合は、学習用パラメータや学習データを見直し、再学習を行います。
- 6.
-
活用:ファインチューニング後のモデルを、実際のシステムやサービスに組み込みます。組み込み後も、モデルを稼働させ続けるためのGPU環境を継続的に確保しておく必要があります。
このステップの中で特に時間が掛かるのが「2.学習データを用意」と「4.学習」です。
「2.学習データを用意」では、学習させたい知識や振る舞いを的確に反映したデータを、十分な質と量で用意する必要があるため、時間が掛かります。加えて、モデルの特性に合わせた適切なデータ形式を見極める作業も発生します。
「4.学習」では、学習用パラメータの組み合わせによって結果が大きく変わるため、1回の学習で終わらせず複数パターンを試行錯誤しながら進める必要があるため、時間が掛かります。さらに、GPU環境の確保や1回あたりの学習にかかる時間そのものも影響します。
一連のファインチューニングで必要なGPU環境は、モデルの種別によって確保の仕方が異なります。ローカルLLMの場合、学習から推論、活用まで、すべて自前で用意したGPU環境上で完結させる必要があります。自社でGPU搭載サーバーを保有する方法もありますが、基本的にはクラウド上のGPUを調達する方法が運用の手間が掛かりません。例えば、AWSであれば、GPUを搭載したEC2インスタンスや、機械学習の実行環境をマネージドサービスとして提供するSageMakerなどを活用できます。
一方、パブリックLLMの中にも、GPT-4o miniのようにファインチューニング機能自体を提供しているモデルがあります。この場合、利用者側でGPUを調達する必要はなく、プロバイダー側が用意したGPU環境上で学習や推論を行うことができます。
ファインチューニングの主なアプローチ
ここまでは、ファインチューニングの一般的な流れをご紹介してきました。ここからは、具体的にどのようなアプローチや手法があるのかをご紹介します。まず、ファインチューニングには大きく分けて2つのアプローチがあります。1つは、モデルの全パラメータを更新するFull Fine-Tuningです。モデルの精度を最大限まで高められる一方、多くの計算リソース(GPUや学習時間)を要するため、気軽に試すことは現実的ではありません。もう1つが、一部のパラメータのみを効率的に更新するPEFT(Parameter-Efficient Fine-Tuning)です。一般的な企業やユーザーがファインチューニングを行う場合、少ない計算リソースで済むPEFTを採用するケースが大半です。
| アプローチ | 概要 | メリット | デメリット |
|---|---|---|---|
| Full Fine-Tuning | モデルの全パラメータを対象に学習 | 専門性を最大限まで高められる | 元の知識を失う「破壊的忘却」のリスクがある/膨大な計算リソースと長時間の学習が必要 |
| PEFT | モデルの一部のパラメータのみを学習 | 少ない計算リソースで高速に学習できる | Full Fine-Tuningに精度が及ばない場合がある |
PEFTの中でも、モデルに少量の追加パラメータ(アダプター)を付与し、そのアダプター部分のみを学習で更新していく手法がLoRA(Low-Rank Adaptation)です。LoRAはMicrosoft Researchが2021年に発表した手法で、近年ではLoRAをベースにした高速化手法であるQLoRAも広く使われています。後ほどご紹介する挑戦においても、こちらのQLoRAを使用してローカルLLMのファインチューニングを実施しました。
具体的なファインチューニングの流れ(gpt-oss-20bの場合)
ここでは、ローカルLLM「gpt-oss-20b(2025年8月に発表されたオープンウェイトモデル)」を例に、ファインチューニングの具体的な流れをご紹介します。後述するQ&Aエージェントでの検証においても、gpt-oss-20bについては同様の流れでファインチューニングを行っています(もう一方の検証対象であるGPT-4o miniは、OpenAI Platformが提供するファインチューニング機能を利用しているため、流れが異なります。詳細は後述します)。
学習データの作成
学習データは基本的に、ユーザからの質問を表す「入力」と、モデルが生成すべき「応答」の組で作成します。ただし、gpt-oss-20bの場合は、これに加えて「思考過程」も学習データに含める必要があります。gpt-oss-20bは、回答の前に思考過程(Reasoning)を出力する推論能力を備えたモデルであり、「入力」と「応答」のみで構成した学習データでファインチューニングを行うと、この思考過程を出力する能力自体が失われてしまうためです。実際に、後述するQ&Aエージェントでの検証でも、学習後に思考過程が出力されなくなる現象を確認しました。
また、gpt-oss-20b用の学習データは、最終的に以下のようなGPT-OSS独自のチャットテンプレート形式であるHarmony(ハーモニー)形式に変換する必要があります。
<|start|>system<|message|>You are ChatGPT, a large language model trained by OpenAI.
Knowledge cutoff: 2024-06
Current date: 2026-03-08
Reasoning: medium
# Valid channels: analysis, commentary, final. Channel must be included for every message.<|end|>
<|start|>developer<|message|># Instructions
あなたは優秀なAIアシスタントです。質問に対して簡潔に回答してください。<|end|>
<|start|>user<|message|>太陽系で一番大きな惑星は何ですか?<|end|>
<|start|>assistant<|channel|>analysis<|message|>ユーザーは太陽系で最大の惑星について尋ねている。正解は木星。簡潔な回答が求められているため、端的に答える。<|end|>
<|start|>assistant<|channel|>final<|message|>太陽系で一番大きな惑星は「木星」です。<|return|>
学習~活用の流れ
学習データを準備した後は、実際にファインチューニングと評価を行っていきます。評価に合格したモデルは、実際のサービスに組み込まれていきます。ここでは、後述するQ&Aエージェントでの検証で採用した技術構成(図3)を例に、学習から活用までの具体的な流れをご紹介します。
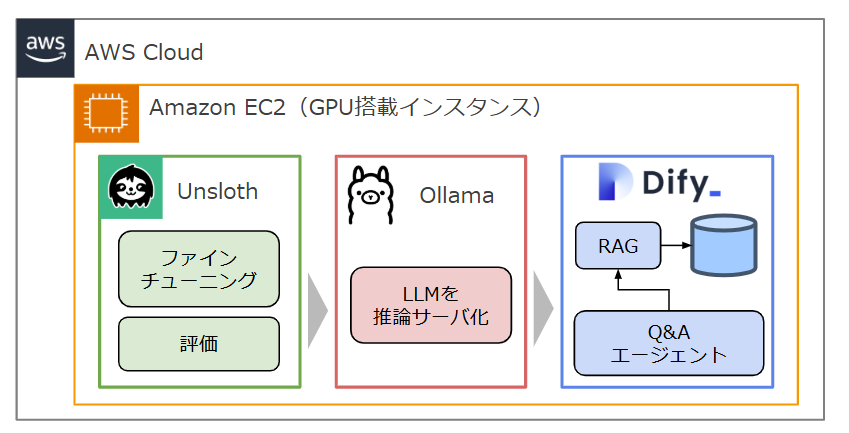
図3. ファインチューニングの技術構成
図3の例では、AWS環境内でGPUを搭載したEC2インスタンス上にOSSのファインチューニング用ライブラリであるUnslothを導入し、gpt-oss-20bのファインチューニング(QLoRA)を行っています。Unslothは、通常のファインチューニングに比べて少ないメモリで高速に学習を行えることが特徴のライブラリで、LLMはもちろん、VLM(テキストだけでなく画像も扱えるモデル)のファインチューニングにおいてもよく使用されるライブラリです。
学習を終えたモデルは、ローカルLLMの実行環境であるOllamaにホスティングすることで、推論サーバとして稼働させることができます。そのうえで、ノーコードでAIアプリケーションを構築できるプラットフォームであるDifyから、Ollama上のモデルに接続する形でRAGやAIエージェントを構築することも可能です。このように、ファインチューニング後のモデルは、Difyのような任意のプラットフォームや、独自に開発したシステムからも呼び出して活用できる点が特徴です。
Q&Aエージェントでファインチューニングに挑戦
ここからは、これまでご紹介してきた流れに沿って実際に手を動かした挑戦内容をご紹介します。今回は、社内でも比較的容易に入手できるデータとして、社内規程集を題材に、Q&Aエージェントを構築してファインチューニングの効果を検証しました。
社内規程集は、社内規則をまとめたルールブックのようなもので、社外に公開できない機密性の高い情報です。これをモデルに学習させて会社固有の知識を獲得させれば、それを基盤としたQ&Aエージェントによって精度の高い回答を実現できるのではないかと考えました。
(注意)今回の挑戦は、あくまでファインチューニングのはじめの一歩とした技術習得(ファインチューニングの一連の流れを試す)を目的として実施しています。Q&Aエージェントは、それを手軽に検証できる題材として選びました。ただ、この挑戦を通じて、ファインチューニングはQ&Aエージェントの高精度化に向けた知識の獲得にはあまり向いていないという結果が得られたため、ファインチューニングが真に効果を発揮する場面については、改めて検討する必要があると考えています。
検証手順の紹介
検証にあたっては、社内規程集の知識をファインチューニングで学習させる、またはRAGとして参照させることで、対象のLLMに組み込みました。そのうえで、ユーザーから社内規程に関する質問が寄せられた際に、モデルがどれだけ正確に回答できるかを評価し、RAGとファインチューニングのどちらにどのような技術的優位性があるかを比較しました。
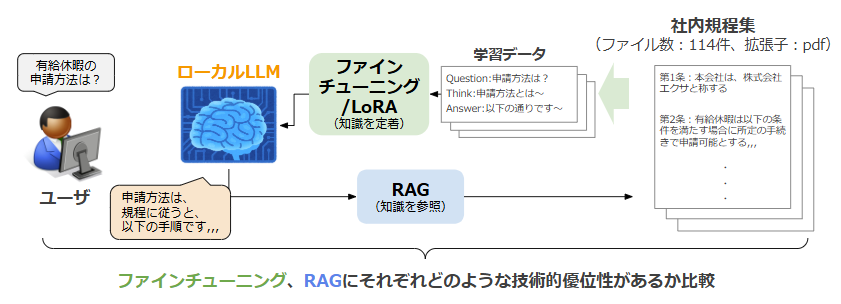
図4. 社内規程Q&AエージェントにおけるファインチューニングとRAGの比較イメージ
ファインチューニングとRAGがそれぞれ回答精度にどのように寄与するかを切り分けて評価するため、表2に示す4パターンのQ&Aエージェントを構築しました。素のLLMをベースラインとし、そこにファインチューニングとRAGを個別に、あるいは組み合わせて適用することで、各技術の効果を比較できるようにしています。
| パターン | ファインチューニング | RAG |
|---|---|---|
| パターン1(ベースライン) | - | - |
| パターン2 | ○(規程集で学習) | - |
| パターン3 | - | ○(規程集を参照) |
| パターン4 | ○(規程集で学習) | ○(規程集を参照) |
また、検証で使用するLLMには、表3に示す2種類のモデルを採用しました。gpt-oss-20bは、前章で紹介した自前のGPU環境でファインチューニングから稼働までを完結できるローカルLLMです。一方のGPT-4o miniはローカルLLMではありませんが、ファインチューニングによる精度の変化がモデル自体に起因するのか、それとも技術スタックに起因するのかを分析できるように、OpenAI Platform上で提供されているファインチューニング機能を利用して検証しました。
| モデル | 発表時期 | 種別 | パラメータ数 |
|---|---|---|---|
| gpt-oss-20b | 2025年8月 | ローカルLLM(自前環境でファインチューニング・稼働が可能) | 約21B |
| GPT-4o mini | 2024年7月 | パブリックLLM(OpenAI Platform上でファインチューニング・稼働が可能) | 非公開 |
学習データには、社内規程を基にしたQAペアデータ(前章で紹介したinput・analysis・outputの3要素を含む形式)を作成しました。1件ずつ人手で作成するのではなく、ファインチューニング対象とは別に用意したローカルLLM(gpt-oss-20b)を使用し、社内規程集(114件のPDFファイル)の内容から、実際に問い合わせが想定される質問文と、それに対する思考過程・回答文を自動生成させました。この過程で、gpt-oss-20bのような小規模なローカルLLMでも、十分な品質の学習データを作成できることを確認できました。最終的に、約15,000件のQAペアデータを作成しました。
学習データとは別に、学習後のモデルの回答精度を評価するための評価データも用意しました。評価データは、作業者2名が社内規程集に目を通し、想定される質問文・理想的な回答文・評価観点をセットにして、計200件分作成しました。
想定される質問文:有給休暇の申請方法は?
理想的な回答文:申請方法は以下の手順になります。1. 申請者本人がシステムにアクセスする。2. 必要情報(**、**)を記載する。3. 上長は申請内容を確認して承認する。~
評価観点:何かしらの申請手順を提示できていること/申請者本人が申請する旨が含まれていること/必要情報を提示できていること/上長の承認が必要である旨が含まれていること~
また、評価観点への適合度に応じて、表4のように評価スコアを5段階で定義しました。評価スコアが高いほど、Q&Aエージェントの回答精度が高いことを意味します。
| スコア | 内容 |
|---|---|
| 1 | 質問に合致しない回答であり、回答としてふさわしくない |
| 2 | 評価観点を満たさない、社内情報を含まない一般的な回答 |
| 3 | 評価観点の一部を満たす回答 |
| 4 | 評価観点をすべて満たす回答 |
| 5 | 評価観点をすべて満たし、かつ有益なアドバイスが含まれる回答 |
この評価観点と評価スコアの定義を用いて、Q&Aエージェントの回答を評価する仕組みには「LLM-as-a-Judge」を活用しました。LLM-as-a-Judgeとは、LLMの回答精度を人手ではなくLLMに判定させる手法です。今回のように多数のパターン・データに対して評価を行う場合、人手だけでは負荷が大きいため、LLMを用いて機械的かつ効率的に評価できる仕組みを取り入れました。今回の評価スコアによる精度判定では、作業者2名による評価スコアと、gpt-oss-20bによる評価スコアを比較したところ、両者の乖離は小さく、小規模なgpt-oss-20bでも十分な精度で評価できることを確認できました。
検証結果(速度、GPU価格、評価スコア)
GPU(NVIDIA Tesla T4)が搭載されたEC2インスタンス(g4dn.12xlarge、利用料金は1時間あたり5$)を用いてgpt-oss-20bのファインチューニングと推論を実行したところ、表5の結果となりました。なお、1epochあたりのステップ数について、今回の検証条件では1,837 stepとなりましたが、こちらの値は、学習データ数と学習用パラメータ(バッチサイズなど)の組み合わせなどの実施条件に応じて変動します。
| 学習時間(1epoch:1,837 step) | 学習にかかったGPU使用料金 | 推論時間(1回分の回答生成) |
|---|---|---|
| 77,040秒(約21時間) | 105$ | 29秒 |
学習データ1周分(1epoch)の学習には約21時間、推論(1回分の回答生成)には平均29秒を要しました。ファインチューニングの学習は一般的に1~3epoch程度繰り返すことが効果的とされていることに加え、学習用パラメータの組み合わせが学習の成否を左右します。実際の検証でも、1epochの学習だけでなく、学習用パラメータを変えながら何度も試行錯誤を重ねました。また、推論速度はサービスに組み込んでユーザーに提供する際のUI/UXを大きく左右する要素です。これらを踏まえると、学習を本格的に運用する際には、より高性能なGPUを用意し、学習・推論それぞれにおいて時間とコストを抑えられる環境を整えることが望ましいと考えます。
次に、回答精度の評価結果です。表2で示した4パターンのQ&Aエージェントについて、評価スコア(200件の評価データに対する平均値、5段階評価)を算出しました。gpt-oss-20bでの結果を表6、GPT-4o miniでの結果を表7に示します。なお、評価スコアはgpt-oss-20bでは作業者2名とLLMによる評価スコアの平均(計3名分)、GPT-4o miniではLLMによる評価スコアを3回算出した平均を採用しています。
| パターン | ファインチューニング | RAG | 評価スコア | 備考 |
|---|---|---|---|---|
| パターン1(ベースライン) | - | - | 2.30 | ー |
| パターン2 | ○ | - | 2.48 | 評価スコアはわずかに向上したものの、多くの回答が学習データではなく一般知識やハルシネーションに基づいており、学習データに含まれる回答を暗記できていなかった |
| パターン3 | - | ○ | 3.65 | ー |
| パターン4 | ○ | ○ | 2.38 | RAG用の検索ツールの実行をスキップして、元々のモデルが持つ一般知識からのみ回答する挙動が生じ、評価スコアが大きく低下した |
| パターン4(検索ツールを必ず実行) | ○ | ○ | 3.73 | 検索ツールを必ず実行して、検索したドキュメントを必ず参照するようにフローを調整したところ、評価スコアがパターン3(RAGのみ)をわずかに上回った |
| パターン | ファインチューニング | RAG | 評価スコア | 備考 |
|---|---|---|---|---|
| パターン1(ベースライン) | - | - | 2.44 | ー |
| パターン2 | ○ | - | 2.17 | 評価スコアが低下した |
| パターン3 | - | ○ | 3.52 | ー |
| パターン4 | ○ | ○ | 2.12 | RAG用の検索ツールの実行をスキップして、元々のモデルが持つ一般知識からのみ回答する挙動が生じ、評価スコアが大きく低下した |
| パターン4(検索ツールを必ず実行) | ○ | ○ | 3.37 | 検索ツールを必ず実行して、検索したドキュメントを必ず参照するようにフローを調整したものの、評価スコアはパターン3(RAGのみ)の水準まで回復しなかった |
まず、RAGを用いない場合(パターン1とパターン2の比較)、ファインチューニングを行っても評価スコアは伸び悩みました(gpt-oss-20bで2.30→2.48、GPT-4o miniで2.44→2.17)。いずれも評価スコアは2点台にとどまっており、社内情報を含まない一般的な回答に終始しています。この結果から、ファインチューニングを行っても、学習データに含まれる知識がモデルに定着しなかったと考えられます。
次に、RAGを用いる場合(パターン3とパターン4の比較)に着目すると、ファインチューニングを行った時の評価スコアは、いずれのモデルでもファインチューニングを行わない場合(パターン3)を大きく下回りました(gpt-oss-20bで3.65→2.38、GPT-4o miniで3.52→2.12)。これは、ファインチューニングによってRAG用の検索ツールの実行がスキップされ、自分が持っている知識の中からのみ回答する挙動に変化したことが要因です。
そこで、パターン4を改良し、検索ツールの実行と、検索したドキュメントの参照を必ず行うようにフローを調整しました。しかし、この改良版をパターン3(RAGのみ)と比べても、評価スコアは伸び悩む結果となりました(gpt-oss-20bで3.65→3.73、GPT-4o miniで3.52→3.37)。評価スコアが3点台にとどまっていることから、RAGによって得られる情報以上の知識は、学習データを通じてモデルに定着しなかったと考えられます。
以上の結果から、少なくとも今回検証した学習データやファインチューニング手法の範囲では、ファインチューニングは回答精度の向上に直接的には寄与しにくく、むしろRAGとの組み合わせ方の方が精度を左右することが分かりました。
考察(ファインチューニングと継続事前学習)
今回の挑戦の主目的は、ファインチューニングという技術に関する基礎的なノウハウ(ツールの使い方、学習データの作り方、環境構築のポイントなど)を蓄積することにあり、その点では一連の学習パイプラインを実際に構築・運用できたという成果が得られました。一方で、Q&Aエージェントとしての回答精度向上という観点では、前述のとおり課題も見えてきました。ここでは、その要因を掘り下げて考察します。
本挑戦を企画した2025年後半の時点では、生成AIに知識を追加する手段としてファインチューニングにも一定の期待がありました。実際、OpenAIやUnslothのガイドにおいても、モデルをドメインに適応させる際はまずLoRAによるファインチューニングを試すことが推奨されていました。しかし、その後、社会的にも検証が進み、ファインチューニングが本来担うべき役割が徐々に整理されてきています。この流れを踏まえ、ファインチューニングとよく似た技術である「継続事前学習(CPT:Continuous Pre-training)」を紹介します。両者の違いを表8に整理しました。
| 手法 | 学習データ | 得意なこと | 例 | 今回の検証への考察 |
|---|---|---|---|---|
| ファインチューニング(SFT:Supervised Fine-Tuning) | QAペアデータ(社内規程を基に作成) | 「振る舞い」「思考ロジック」「出力形式」の調整 | 申請手続きの審査手順や思考ロジックの学習、AIアシスタントとしての振る舞い方(UI/UX)の学習 | 今回はQ&A形式(一問一答)で学習させたため、質問に即答する(RAG用の検索ツールをスキップする)振る舞いが学習されたと考えられる |
| 継続事前学習(CPT:Continuous Pre-training) | 生データ(社内規程そのもの) | 「専門用語」「概念」を知識として埋め込むこと ※覚えられる知識量には限界があり、RAGとの組み合わせが重要 | 業界知識や専門知識の埋め込み、規程集の暗記 | 回答精度の向上が目的なら、ファインチューニングの前段として継続事前学習を行い、社内情報を知識として定着させておいた方が良かった可能性がある(推測) |
なお、ファインチューニング・継続事前学習のいずれも、今回採用したLoRAをベースにしたQLoRAによって効率的に学習を進められる点は共通しています。
この整理を踏まえると、ファインチューニングは「振る舞い」を調整する技術であり、社内規程のような知識をモデルに定着(暗記)させることを目的とするなら、継続事前学習を検討する方が適切だったと考えられます。今後、追加の検証が必要だと考えます。
検証結果から得られた気づき
もし今回のような機密性の高いQ&Aエージェントを安価に構築したいと考える場合、検証結果を踏まえると、状況に応じて次の2点のTipsにまとめられます。
1点目:RAGを未導入の場合、ファインチューニングよりもRAGの導入を優先すべき
-
ファインチューニングだけでは、学習データの知識が十分に定着せず、回答がモデル本来の知識の範囲に留まってしまいます。
-
更新頻度が高いデータを扱う場合、内容が変わるたびに再学習が必要になるため、ファインチューニングは運用コストの面でも不向きです。
-
(要検証)継続事前学習であれば、学習データの知識が定着し、精度向上に寄与する可能性があります。
2点目:RAGを導入済みの場合、ファインチューニングよりもRAGの精度改善を優先すべき
-
ファインチューニングをそのまま適用するだけでは、精度向上には直接的には寄与しにくいと考えられます。
-
(要検証)「ドキュメントから回答を的確に抽出する」「検索ツールを正しく選択・実行する」といった、回答に至るまでの思考ロジックをファインチューニングで学習させることで、精度向上に寄与する可能性があります。
-
(要検証)継続事前学習であれば、学習データの知識が定着し、精度向上に寄与する可能性があります。
まとめ
本記事では、ローカルLLMのファインチューニングについて、一般的な流れや環境構築の考え方をご紹介した上で、社内規程集を題材としたQ&Aエージェントの構築を通じた挑戦内容をご紹介しました。
今回のQ&Aという題材では、ファインチューニングによる回答精度の向上効果は確認できませんでした。ただし、考察でも触れたとおり、これは「知識の定着」を目的とした使い方が今回のケースに合っていなかったためであり、申請手続きの審査手順の学習やAIアシスタントとしての振る舞い方(UI/UX)の調整など、「振る舞い」を調整する用途では、ファインチューニングが有効に働く可能性はあります。
エクサでは、「ai-with」「たまちゃん」「Omni-Q」といったAIエージェントソリューションの構築・運用実績に加えて、今回ご紹介したようなローカルLLMやファインチューニングといった基礎技術の習得にも継続的に取り組んでいます。機密情報を扱う現場での生成AI活用にお悩みの方は、こうした知見や実績を踏まえながら、ぜひ皆様のドメイン知識をもとに一緒にアイデアを模索・検証させていただければと思います。ご興味をお持ちの方は、エクサにご相談ください。
また、LLMの調整方法には、今回ご紹介したファインチューニング(LoRA)以外にも、継続事前学習やアライメントといった手法、モデルマージやタスクベクトルといった業界の垣根を越えた知識統合の技術、さらにはLLM以外の基盤モデル(VLM、VLAなど)の構築・調整まで、検証すべきテーマがまだ数多く残されています。エクサでは、こうしたテーマについても、LLMの調整方法の特徴に応じた使い分けや「成功パターン」を、お客様と共同で研究していきたいと考えています。
本記事の内容が、皆様の生成AI活用のヒントとなれば幸いです。最後までご覧いただき、ありがとうございました。
参考資料
本記事に記載されているロゴ、システム名称、 企業名称、製品名称は各社の登録商標または商標です。
執筆者紹介
連載コラム:エクサの生成AIチャレンジ日記
本コラムでは、エクサ社内における生成AIの活用に向けた技術的な取り組みと、実際の業務適用事例をご紹介いたします。生成AIによる業務効率化や新たな価値創造のヒントとなれば幸いです。
関連コラム
関連ソリューション
関連事例
お問い合わせ
CONTACT
Webからのお問い合わせ
エクサの最新情報と
セミナー案内を
お届けします